Kubernetes startet Container nicht einfach, es hält einen Sollzustand. Du beschreibst, was laufen soll, und das Cluster sorgt dafür, dass es so bleibt. Wer das verinnerlicht, hat die meisten Probleme schon vermieden.
Die nützlichen Befehle für den Alltag stehen gesammelt im kubectl-Spickzettel.
Aufbau eines Clusters
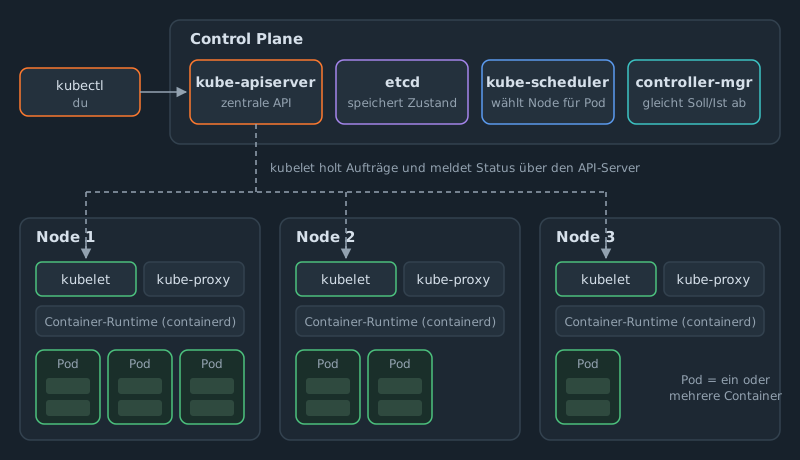
Ein Cluster besteht aus der Control Plane und den Nodes, auf denen deine Anwendungen laufen.
kube-apiserver: die einzige Stelle, mit der alle sprechen.kubectl, die Nodes und alle internen Komponenten gehen über die API.etcd: die Datenbank mit dem gesamten Clusterzustand. Wer etcd sichert, sichert das Cluster.kube-scheduler: entscheidet, auf welchem Node ein neuer Pod landet.kube-controller-manager: vergleicht ständig Soll und Ist. Fehlt ein Pod, startet er einen neuen.kubelet: läuft auf jedem Node, startet die Container über die Container-Runtime und meldet den Zustand zurück.kube-proxy: sorgt auf jedem Node dafür, dass Services erreichbar sind.
Die wichtigsten Objekte
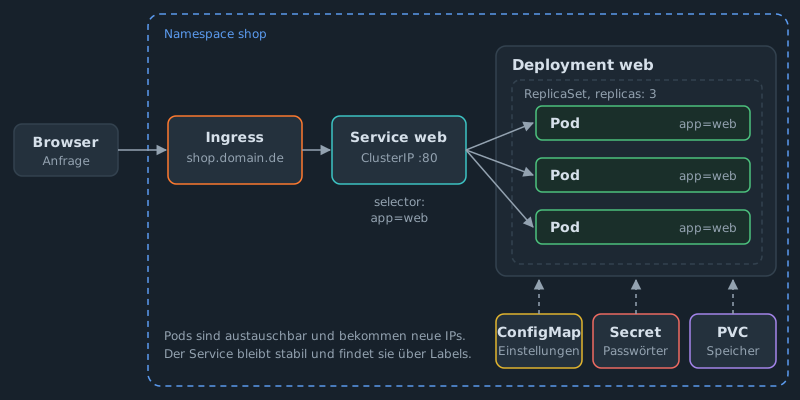
| Objekt | Wofür |
|---|---|
| Pod | Kleinste Einheit, ein oder mehrere Container mit gemeinsamer IP. Kurzlebig. |
| Deployment | Beschreibt, welches Image in wie vielen Kopien laufen soll. Legt ReplicaSets und Pods an. |
| Service | Feste Adresse und Lastverteilung vor wechselnden Pods. Findet die Pods über Labels. |
| Ingress | Leitet HTTP(S) von außen anhand von Hostname und Pfad an Services weiter. |
| ConfigMap | Einstellungen als Umgebungsvariablen oder Dateien. |
| Secret | Wie ConfigMap, für Passwörter und Schlüssel. |
| PersistentVolumeClaim | Fordert Speicher an, der einen Pod-Neustart überlebt. |
| Namespace | Trennt Anwendungen, Rechte und Kontingente innerhalb eines Clusters. |
Für zustandsbehaftete Anwendungen wie Datenbanken gibt es statt Deployment das StatefulSet, für Agenten auf jedem Node das DaemonSet, für einmalige oder zeitgesteuerte Aufgaben Job und CronJob.
Deklarativ arbeiten
Lege Objekte nicht mit einzelnen Befehlen an, sondern beschreibe sie in YAML-Dateien und spiel sie mit kubectl apply ein. Die Dateien gehören in Git. So ist jederzeit nachvollziehbar, was im Cluster laufen soll, und du kannst es auf einem neuen Cluster in Sekunden wiederherstellen.
Ein vollständiges Beispiel mit Deployment und Service, das die Regeln aus dem nächsten Abschnitt umsetzt:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web
  namespace: shop
  labels:
    app: web
spec:
  replicas: 3
  selector:
    matchLabels:
      app: web
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxUnavailable: 0
      maxSurge: 1
  template:
    metadata:
      labels:
        app: web
    spec:
      containers:
        - name: web
          image: registry.domain.de/shop/web:1.5.0
          ports:
            - containerPort: 8080
          envFrom:
            - configMapRef:
                name: web-config
          env:
            - name: DB_PASSWORD
              valueFrom:
                secretKeyRef:
                  name: web-db
                  key: password
          resources:
            requests:
              cpu: 100m
              memory: 128Mi
            limits:
              memory: 256Mi
          readinessProbe:
            httpGet:
              path: /healthz
              port: 8080
            periodSeconds: 5
          livenessProbe:
            httpGet:
              path: /healthz
              port: 8080
            initialDelaySeconds: 15
            periodSeconds: 10
---
apiVersion: v1
kind: Service
metadata:
  name: web
  namespace: shop
spec:
  selector:
    app: web
  ports:
    - port: 80
      targetPort: 8080
Einspielen, vorher die Änderungen ansehen:
kubectl diff -f web.yaml
kubectl apply -f web.yaml
So nutzt du Kubernetes richtig
Keine einzelnen Pods anlegen. Ein Pod ohne Deployment wird nach einem Node-Ausfall nicht neu gestartet. Nutze immer ein Deployment, StatefulSet oder DaemonSet.
Feste Image-Tags statt
latest. Mitlatestweißt du nicht, welche Version läuft, und ein Rollback auf „die vorige Version“ ist nicht möglich. Verwende eine Versionsnummer wie1.5.0.Requests und Limits setzen.
requestsreserviert Ressourcen, danach plant der Scheduler. Ohne Requests landen zu viele Pods auf einem Node, und unter Last fliegen die falschen raus. Ein Memory-Limit schützt den Node vor einem Container mit Speicherleck. Mit einem CPU-Limit sei vorsichtig: Es drosselt den Container auch dann, wenn der Node frei ist.Readiness und Liveness Probe definieren. Die Readiness Probe entscheidet, ob ein Pod Anfragen bekommt. Die Liveness Probe startet einen hängenden Container neu. Die Liveness Probe sollte nur prüfen, ob der Prozess selbst lebt, nicht ob die Datenbank erreichbar ist. Sonst startet bei einem Datenbankausfall jeder Pod in Schleife neu.
Rolling Updates nutzen. Ändert sich das Image, ersetzt Kubernetes die Pods nacheinander. Mit
maxUnavailable: 0bleibt die volle Kapazität erhalten, neue Pods bekommen erst Traffic, wenn ihre Readiness Probe grün ist.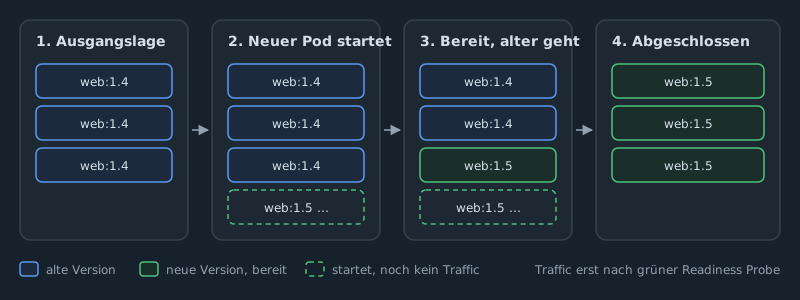
Geht etwas schief, rollst du mit einem Befehl zurück:
kubectl rollout undo deployment/web -n shopNamespaces verwenden. Lege für jede Anwendung oder Umgebung einen eigenen Namespace an, statt alles in
defaultzu packen. Rechte,ResourceQuotaund das Aufräumen lassen sich dann pro Namespace steuern.Secrets nicht im Klartext in Git. Ein Secret ist nur Base64-kodiert, nicht verschlüsselt. Lege es direkt im Cluster an oder verschlüssele es vor dem Commit, zum Beispiel mit Sealed Secrets oder SOPS.
Mindestens zwei Replicas für alles, was erreichbar sein muss. Mit einem einzigen Pod ist jedes Update und jede Node-Wartung ein kurzer Ausfall.
Rechte knapp halten. Gib Benutzern und Pipelines per RBAC nur die Rechte im eigenen Namespace. Pods brauchen meist gar keinen Zugriff auf die Kubernetes-API.
Ein kleines Cluster mit k3s
Zum Lernen und für kleine Umgebungen eignet sich k3s. Es bringt Control Plane, containerd, einen Ingress-Controller (Traefik) und den metrics-server in einer Binärdatei mit. Installation auf einem Linux-Server:
curl -sfL https://get.k3s.io | sh -Danach läuft der Dienst k3s, und die Zugangsdaten liegen in /etc/rancher/k3s/k3s.yaml. Prüfen, ob der Node bereit ist:
sudo k3s kubectl get nodesWillst du von deinem Rechner aus arbeiten, kopiere /etc/rancher/k3s/k3s.yaml nach ~/.kube/config und ersetze darin 127.0.0.1 durch die Adresse des Servers, zum Beispiel 192.0.2.10.
Hinweis
Kubernetes lohnt sich, wenn du mehrere Anwendungen auf mehreren Servern betreibst und Updates ohne Ausfall brauchst. Für eine Handvoll Container auf einem einzelnen Server ist Docker Compose oft die einfachere und völlig ausreichende Wahl.
Inhalt